Audit contenu : vérifier chaque question avant l'apprenant
Sur le premier parcours audité, 1 question sur 20 empêchait l'apprenant de répondre. Toutes ont été corrigées.
D'après leurs retours, la satisfaction des apprenants d'une plateforme EdTech se joue d'abord sur la qualité du contenu.
Avec une learning designer, nous avons soumis chaque question d'un parcours à une grille de six critères. Des agents IA encadrés l'ont appliquée, et des contrôles automatiques l'ont complétée.
Les corrections, relues avant d'être appliquées, sont en production depuis la semaine du 28 septembre 2026.
Pourquoi auditer
Dans le formulaire du site, 1 retour sur 3 concerne le contenu : c’est le constat du premier projet, UserVoice.
J’ai mené ce chantier avec une learning designer. J’ai conçu la grille d’audit et l’outillage qui l’applique ; elle a validé la grille, défini les règles d’écriture des contenus et fait la recette des échantillons.
Le périmètre couvre six parcours de préparation à des certifications de langue. Nous avons commencé par le plus ancien.
Ce que la grille vérifie
La grille compte six critères. Deux portent sur la réponse : la réponse attendue est la bonne, et aucune autre ne se défend aussi bien. Un troisième vérifie que la question contient une explication, et qu’elle n’est pas circulaire. Les trois derniers portent sur la fidélité à la source, la langue et la cohérence.
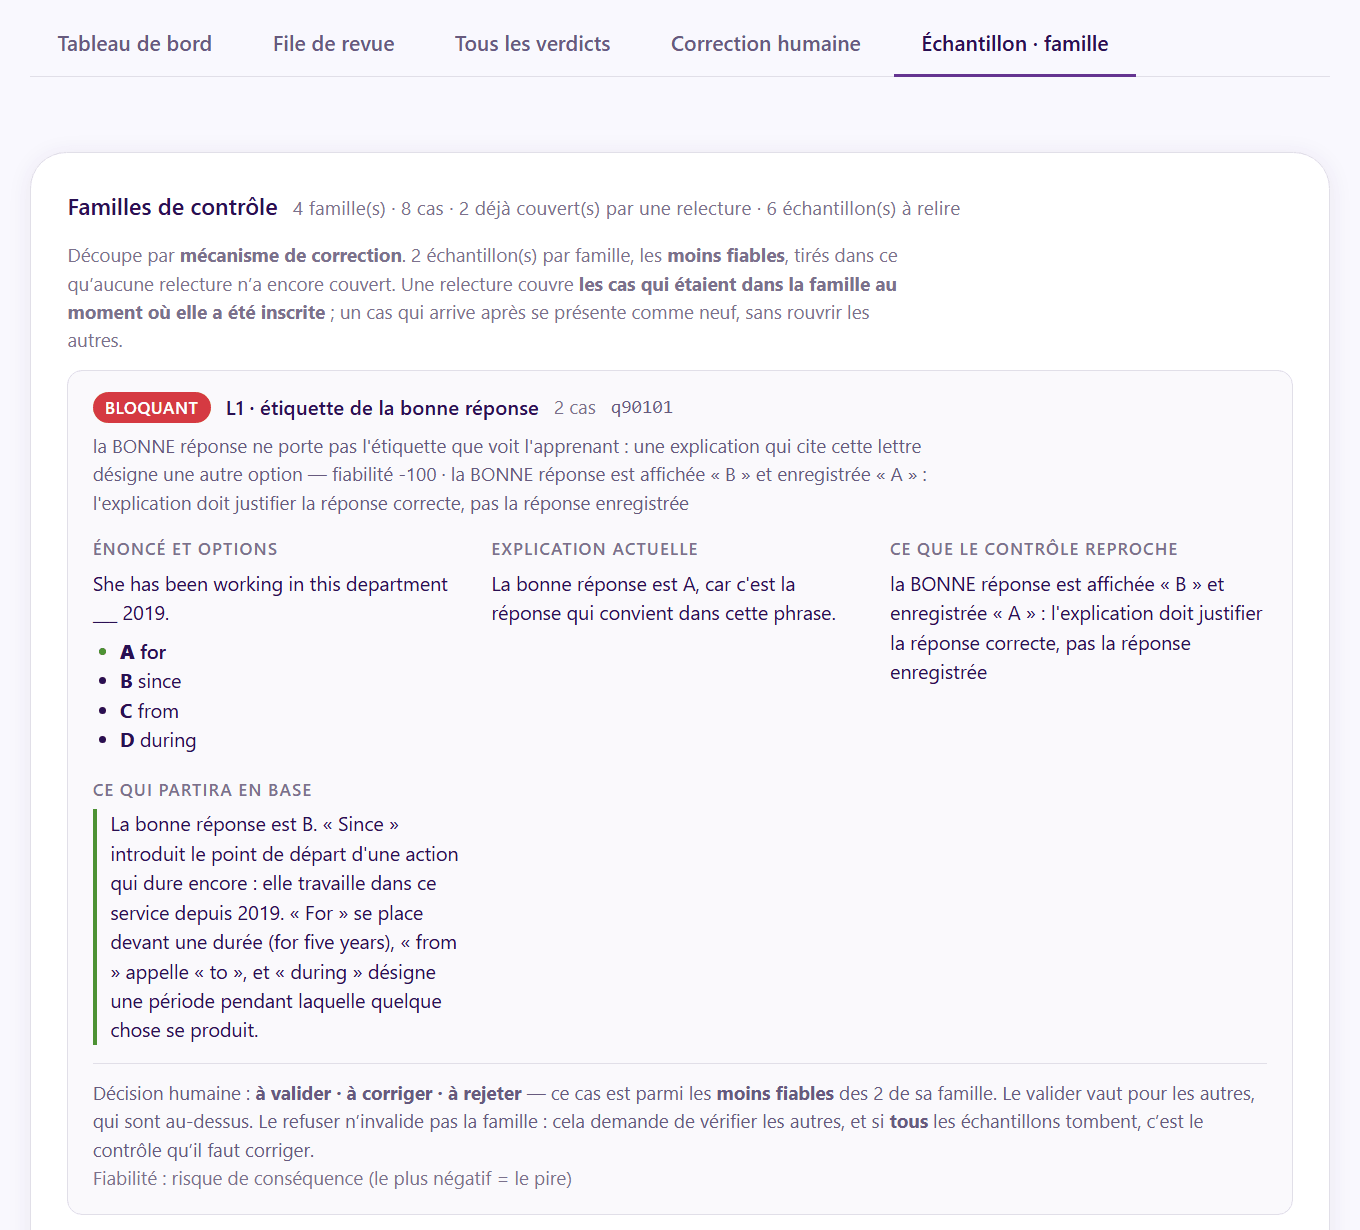
Chaque question reçoit ensuite un verdict parmi quatre : bloquant, majeur, mineur ou rien à corriger. Elle est bloquante quand l’apprenant ne peut pas y répondre. C’est le cas si la réponse attendue est fausse, ou si deux réponses se défendent autant.
Des agents IA appliquent la grille, question par question : des sous-agents de Claude Code, sur abonnement, sans API payante. Le modèle ne juge pas seul. Des contrôles automatiques, qui ne dépendent d’aucun modèle, passent sur tout le corpus. Un bilan donne l’état de chaque question et ce qui lui est reproché.
La chaîne de l’audit, étape par étape :
- Le parcours : ses questions, chacune avec sa réponse et son explication.
- Deux contrôles en parallèle. Les agents IA encadrés appliquent la grille des six critères, question par question. Les contrôles automatiques vérifient que la réponse attendue est la bonne, que l’explication existe et qu’elle n’est pas circulaire.
- Le bilan : un verdict par question, bloquant, majeur, mineur ou rien à corriger.
- La relecture humaine : Jean et la learning designer font la recette des échantillons.
- Les lots de corrections, relus, jamais écrits directement en base.
- La mise en ligne : en préproduction, puis en production.
Ce que nous avons trouvé
Sur le premier parcours audité, 1 question sur 20 a reçu le verdict bloquant. L’apprenant y échouait sans que l’erreur soit la sienne. Chaque correction lui rend la possibilité de répondre juste.
Ce parcours est le plus ancien. Son résultat ne présume pas de la qualité du reste du contenu du site.
Corriger sans casser
L’outil n’écrit jamais directement en base. Il produit des lots de corrections, et une personne relit chacun avant la préproduction. Si un agent se trompe de réponse, le pire est un lot rejeté à la relecture.
Toutes les questions bloquantes du premier parcours ont été corrigées. Les corrections sont passées en production la semaine du 28 septembre 2026.
Ce que j’en retiens
Ce projet m’a laissé 25 règles pour garder la main sur ce qu’un agent produit. Je les ai mesurées en tokens sur quatre semaines et en points de décision tracés dans un registre.
Chaque chantier est chiffré avant de commencer, puis une fois fini. L’écart montre où l’estimation s’est trompée. Une règle qu’on peut vérifier devient un test. Elle se contrôle alors toute seule, sans dépendre de la mémoire de quiconque.
La règle « le relecteur n’est pas l’auteur » résume l’audit. Ce qu’un agent produit, un autre agent le relit, et une personne tranche. Cette règle vaut pour les corrections du contenu comme pour le code que j’écris avec l’IA.
Certaines règles ont coûté cher avant d’être écrites. Sans suivi de version dès le premier fichier, deux semaines de travail sont restées hors historique.
Pour aller plus loin
La grille
- Fidélité à la source. La question ne s'écarte pas de sa source.
- Justesse de la réponse. La réponse attendue est bien la bonne.
- Qualité de l'explication. La question en contient une, qui ne se contente pas de répéter la réponse. Elle est notée de 0 à 3.
- Langue. Le texte est correct.
- Cohérence interne. Les éléments de la question ne se contredisent pas.
- Une seule réponse défendable. Aucune autre réponse ne se défend aussi bien que la bonne.
Les verdicts
- Une question est majeure si elle s'écarte de sa source, ou si son explication n'aide pas l'apprenant.
- Elle est mineure pour une faute de langue, ou pour une explication juste mais perfectible.
- Un critère compte en défaut seulement s'il a été vérifié. Ce qu'on n'a pas pu mesurer ne devient pas un reproche.
Les contrôles automatiques
- L'explication doit parler du même audio que la question.
- La mise en forme du contenu doit rester intacte.
- Le texte doit être dans la bonne langue.
Ce que disaient les retours
- Près d'un commentaire NPS sur cinq touche à la qualité des explications, des exercices ou des traductions.
Les règles, et ce qu'elles ont coûté
- Environ 30 millions de tokens sur quatre semaines, et 233 points de décision tracés dans un registre.
- Plafonner la taille des modules. Les trois plus gros, entre 5 400 et 7 600 lignes, étaient aussi les plus réécrits.
- Lire le nom des champs dans la donnée au lieu de le supposer.